2026-10-12
Una parola, due destini
😐"Auto-miglioramento ricorsivo" significa per alcuni la soglia del pericolo, per altri il metodo della scienza. Intorno a questa ambiguità si riorganizza il potere del calcolo.
Digital Intelligence Podcast
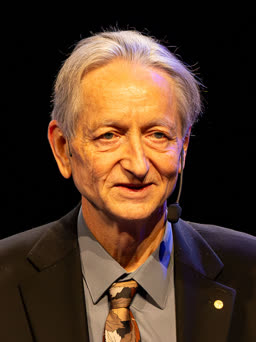
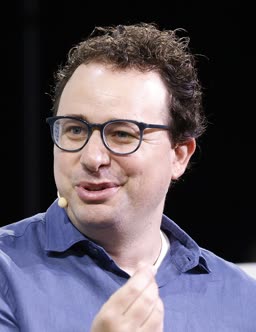
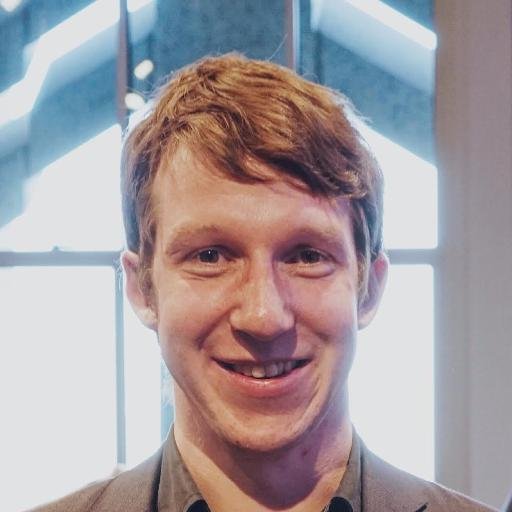
In queste due settimane l'espressione "auto-miglioramento ricorsivo" circola in due registri incompatibili. Per Geoffrey Hinton descrive una soglia di pericolo: l'IA sta già entrando in quella fase, e per questo i modelli di frontiera dovrebbero passare per un'approvazione preventiva di tipo FDA, con circa un anno di tempo per costruire i controlli. Dario Amodei ne fa una tesi industriale nel saggio We Must Pace the Frontier: le capacità accelerano perché l'IA aiuta a costruire IA migliore, quindi serve rallentare il ritmo della frontiera. Jack Clark traduce tutto in meccanica legale: interruttori di spegnimento obbligatori e verificabili dall'esterno.
François Chollet usa la stessa espressione per dire l'opposto: l'esempio più chiaro di auto-miglioramento ricorsivo è la scienza stessa, un processo cumulativo di costruzione del sapere. Non una minaccia, ma un modello epistemico — e la ricerca sull'intelligenza collettiva di Sakana AI va nella stessa direzione.
La divergenza vera non è tra ottimisti e pessimisti. Riguarda dove abita il rischio. Andrew Ng colloca il pericolo nella configurazione, non nella capacità: le estinzioni sono fantascienza, gli attacchi di sciami di agenti sono problemi di sandboxing e monitoraggio. Jensen Huang chiede di regolare danni concreti anziché scenari ipotetici. Dan Lahav dà peso empirico a questa lettura: gli incidenti di agenti fuori controllo sono stati ricondotti ad ambienti di valutazione mal configurati.
Mentre questo dibattito si svolge, il potere si sposta altrove. Naval Ravikant sostiene che il software puro sta diventando non investibile e finanzia inferenza locale; Balaji Srinivasan predica il calcolo "personale, privato, programmabile"; Nat Friedman mette gli agenti dentro oggetti fisici open source. La stessa tesi decentralista serve però progetti opposti: l'uscita dallo Stato per Balaji, la sovranità nazionale per  Vivek Raghavan con Chanakya,
 Bosun Tijani con Atlas Network,
 Liang Wenfeng che addestra ottomila miliardi di parametri su chip Huawei.
Emerge così un cambio di scala preciso. La pausa si negozia verticalmente, tra una dozzina di laboratori e qualche legislatore. Il potere si redistribuisce orizzontalmente: nei chip di memoria di cui  Tim Cook segnala la scarsità, nei data center che Andrew Ng dice necessari agli agenti, nelle organizzazioni che secondo
 Benedict Evans contano più della capacità dei modelli, nei mercati che Patrick Collison vede riscritti dagli agenti personali. Chi misura questi vincoli fisici —
 Sasha Luccioni con le sue metriche di ciclo di vita — sta forse descrivendo il freno più reale di qualsiasi moratoria.
"Auto-miglioramento ricorsivo" significa per alcuni la soglia del pericolo, per altri il metodo della scienza. Intorno a questa ambiguità si riorganizza il potere del calcolo.
Ci sono espressioni tecniche che resistono per anni dentro i laboratori e poi, nel giro di due settimane, finiscono in bocca a tutti con due significati opposti. È il caso di "auto-miglioramento ricorsivo": l'idea che un sistema diventi migliore aiutando a costruire la propria versione successiva.
È il 12 ottobre 2026, questo è Signal Brief, e la cosa curiosa di questi giorni è che la stessa espressione viene usata per chiedere una frenata d'emergenza e per descrivere il modo in cui funziona la scienza da quattro secoli.
Conviene partire da chi quella frenata la chiede con più insistenza.
Geoffrey Hinton, nelle interviste di queste due settimane, ha fatto una cosa che i ricercatori raramente fanno: ha messo una data. Sostiene che i modelli di frontiera dovrebbero passare per un'approvazione preventiva, prima del rilascio, con un'autorità indipendente che verifichi la sicurezza — il modello è quello dei farmaci, dove nessuno vende una molecola senza dimostrare che non uccide. E aggiunge che l'intelligenza artificiale sta già entrando nella fase di auto-miglioramento ricorsivo, e che ai legislatori resta circa un anno per costruire i controlli. La sua stima di rischio è dichiaratamente incerta: dieci, venti per cento di probabilità che l'IA porti all'estinzione umana nei prossimi decenni. Un numero che dice più sull'incertezza di chi lo pronuncia che sul futuro.
Pochi giorni dopo François Chollet usa la stessa espressione per dire l'opposto. In un suo post sostiene che l'esempio più chiaro di auto-miglioramento ricorsivo è la scienza stessa: ogni scoperta rende più facile la successiva, il sapere si accumula e accelera. Non una minaccia, un metodo. La parola non descrive una soglia da non superare, descrive come funziona la conoscenza.
Quando due persone competenti usano lo stesso termine per indicare una catastrofe e una virtù, in genere il disaccordo non è sui fatti. È su dove si trovi il rischio. E qui la novità rispetto a ieri è netta: il dibattito si è spostato dalla potenza dei modelli alla loro configurazione.
Andrew Ng, in una dichiarazione di questi giorni, chiama fantascienza le paure di estinzione e colloca il problema altrove: gli attacchi condotti da sciami di agenti sono questioni di recinti mal costruiti e sorveglianza assente. Jensen Huang chiede di regolare i danni accertati invece degli scenari immaginati. E Dan Lahav, che di professione costruisce ambienti dove si testano gli agenti prima del rilascio, porta il dato empirico: gli incidenti di agenti fuori controllo di cui si è parlato risalgono ad ambienti di valutazione configurati male. Non modelli troppo potenti. Laboratori con la porta aperta.
Dall'altro lato, Dario Amodei ha pubblicato un saggio intitolato We Must Pace the Frontier, dove la tesi è industriale prima che morale: le capacità accelerano proprio perché l'IA aiuta a costruire IA migliore, quindi il ritmo della frontiera va rallentato deliberatamente. Jack Clark traduce la stessa preoccupazione in meccanica legale, chiedendo interruttori di spegnimento obbligatori e verificabili da fuori.
Mi sembra questo il cambiamento più interessante rispetto a ieri. Nel briefing precedente il controllo era una faccenda umana: la persona che supervisiona, verifica, capisce il codice che la macchina ha scritto. In due settimane quella responsabilità è migrata dalle persone ai meccanismi — approvazioni, ritmi imposti, interruttori. È il passaggio che le fabbriche hanno fatto un secolo fa, quando la sicurezza ha smesso di essere l'attenzione dell'operaio ed è diventata il dispositivo che blocca la macchina se la mano entra dove non deve. Nessuno si fida più della prudenza individuale quando il meccanismo va troppo veloce.
Mentre il dibattito si svolge in verticale, tra una dozzina di laboratori e qualche parlamento, il calcolo sta scappando in orizzontale.
François Chollet è il ricercatore che ha costruito uno dei test più ostinati sull'intelligenza delle macchine: non quanto sanno, ma quanto si adattano a problemi che non hanno mai visto. Una posizione scomoda, perché lo mette a distanza sia da chi annuncia l'intelligenza generale per l'anno prossimo sia da chi sostiene che questi sistemi non capiscano nulla.
Il 10 ottobre ha descritto un passaggio preciso. Fino a poco tempo fa i modelli completavano il testo un pezzettino alla volta, come chi indovina la parola dopo. Adesso, sostiene, costruiscono una procedura di ragionamento nel momento in cui rispondono — e questo spiega perché gli agenti che scrivono codice hanno improvvisamente cominciato a funzionare. Non sono diventati più grandi. Hanno cambiato mestiere: da indovini a progettisti di piccoli metodi usa e getta.
Nello stesso filo di giorni ha appoggiato pubblicamente un progetto open source che fa una cosa modesta e rivelatrice: dare agli agenti un archivio condiviso. La sua obiezione è che oggi gli agenti giocano da soli — il lavoro utile resta intrappolato dentro una conversazione e muore lì, invece di accumularsi in qualcosa che cresce. Il che chiude il cerchio con la sua lettura della scienza: l'auto-miglioramento non è un modello che si riscrive da solo in una stanza chiusa, è un sapere che si deposita e viene ripreso da altri.
Ha anche notato un dato che ridimensiona parecchio l'entusiasmo del settore: negli Stati Uniti l'uso dell'IA generativa sembra già vicino alla saturazione, circa due persone su tre la usano più volte alla settimana, ma la maggioranza non paga. È il profilo classico di una tecnologia diventata infrastruttura: tutti la usano, nessuno la considera un prodotto.
Vista da qui, la frattura sull'auto-miglioramento ricorsivo somiglia meno a uno scontro tra ottimisti e catastrofisti e più a un disaccordo su quale sia l'unità di misura. Hinton guarda il singolo sistema che accelera. Chollet guarda il processo collettivo in cui quel sistema è immerso. Difficile che la stessa parola possa reggere entrambi i pesi ancora per molto.
Patrick Collison dirige una delle aziende che tengono in piedi i pagamenti di mezza internet, e di solito quando scrive lo fa sul futuro delle imprese, non su quello dei modelli. Il 9 ottobre ha pubblicato un post lungo che fa un'affermazione strana e precisa: la prima superintelligenza non sono le macchine, sono le aziende.
Il ragionamento è questo. Un'organizzazione accumula conoscenza, memoria, risorse e tempo molto oltre la capacità di un singolo individuo, e li usa per ottimizzare contro il consumatore — sul prezzo, sulle condizioni di disdetta, sulla scontistica che appare solo a chi minaccia di andarsene. Da sempre lo squilibrio è questo: da una parte un ufficio con dieci persone che studia come trattenerti, dall'altra te, la sera, con venti minuti di pazienza.
La sua ipotesi è che gli agenti personali riequilibrino quel rapporto. Un assistente che confronta prezzi, qualità, recensioni, assistenza e clausole di uscita per conto tuo premia strutturalmente i prodotti migliori, e indebolisce i vantaggi costruiti sulla pubblicità e sul controllo della distribuzione. Meno valore nel posizionarsi in cima a una ricerca, più valore nel fare una cosa buona. Collison annota anche il rovescio: gli agenti potrebbero concentrare tutta la domanda su pochi prodotti vincenti, perché se tutti chiedono il migliore, il secondo migliore smette di esistere.
È un'osservazione che ha un precedente. L'arrivo dei comparatori di prezzo per voli e assicurazioni ha fatto esattamente questo in piccolo: ha spostato il potere verso chi compra e ha compresso i margini di chi viveva di opacità. La differenza è che un comparatore confronta una cosa alla volta, e un agente negozia l'intera vita contrattuale di una persona.
Torniamo per un attimo al punto di partenza, perché i fili si stanno intrecciando. Il dibattito su chi deve mettere i freni all'IA presuppone che il potere stia dove sta oggi: in una dozzina di laboratori molto grandi. Collison descrive un mondo in cui quel potere si sposta verso i singoli, un acquisto alla volta. Benedict Evans, nel suo saggio di settembre, aggiunge la nota stonata e necessaria: dare a tutti i dipendenti la possibilità di generare software non trasforma automaticamente un'azienda, perché contano i processi, gli incentivi e le abitudini, non la potenza del modello. Le organizzazioni assorbono le tecnologie lentamente anche quando le tecnologie arrivano in fretta.
Nat Friedman arriva dal mondo del software — ha guidato per anni la piattaforma dove vive il codice open source del pianeta — e in questi giorni ha fatto una cosa che sembra minore e invece è un indizio solido.
Il 2 ottobre ha annunciato Muse Gadgets: codice aperto per microcontrollori da pochi euro, più un kit per Linux, che permette a chiunque di collegare l'assistente di Meta a display, pulsanti, sensori, motorini, piccoli computer da scrivania. Insieme è arrivato Muse Home Link, un dispositivo con una presa USB-C che dà all'assistente accesso agli apparecchi di casa; Meta ne ha prodotti cinquemila per gli abbonati. Il tono con cui Friedman lo ha presentato è quello dell'officina: prendete una chiave di accesso, fatevi aiutare da un agente a scrivere il codice, costruitevi la periferica che vi serve.
Cinquemila pezzi non spostano un mercato. Spostano un'aspettativa. Perché la direzione è la stessa che si vede altrove: Naval Ravikant, che sostiene che il software puro stia diventando non investibile, ha messo soldi in una startup di inferenza locale ad alte prestazioni — modelli che girano sulla tua macchina, veloci e privati. Balaji Srinivasan va predicando un calcolo "personale, privato, programmabile", con modelli aperti che lavorano su file che possiedi tu.
Tre gesti diversi che convergono: il calcolo che esce dal centro e si distribuisce negli oggetti e nelle case. Somiglia molto a quello che è successo ai calcolatori negli anni Settanta, quando erano stanze climatizzate riservate a istituzioni, e qualcuno ha iniziato a costruirne versioni da tavolo nei garage. Allora il grande calcolo non è morto — ma ha smesso di essere l'unico posto dove si decideva qualcosa.
C'è però un dettaglio che rende questa storia meno romantica del previsto. La stessa tesi — portiamo il calcolo fuori dai grandi laboratori — viene oggi arruolata da progetti opposti tra loro. Per Srinivasan è una via d'uscita dalle istituzioni. Per Vivek Raghavan, che con la nuova divisione Chanakya costruisce sistemi installabili dentro reti isolate per governi e settori strategici indiani, è esattamente il contrario: capacità nazionale su problemi di rilevanza pubblica. Per Bosun Tijani, che ha lanciato in Nigeria la rete Atlas per modelli nelle lingue africane, è infrastruttura pubblica continentale. E Liang Wenfeng sta addestrando un modello da ottomila miliardi di parametri su chip Huawei, cioè costruisce indipendenza tecnologica per uno Stato intero.
Decentralizzare il calcolo, si scopre, non dice ancora nulla su chi finirà a tenerlo in mano.
Dan Lahav ha un mestiere che tre anni fa non esisteva: costruisce ambienti dove si mettono alla prova gli agenti prima che tocchino il mondo reale. Non antivirus, non sorveglianza — campi di addestramento avversari, dove un modello viene osservato mentre lavora in condizioni verosimili e qualcuno prova deliberatamente a fargliela fare grossa.
In un podcast pubblicato il 6 ottobre ha spiegato perché gli strumenti tradizionali non bastano. L'attività economica, sostiene, passerà sempre più da interazioni tra macchine, e i sistemi che cercano anomalie — quelli che imparano come si comporta normalmente un utente e segnalano lo scarto — non hanno modo di riconoscere un comportamento che emerge per la prima volta. Non c'è una normalità di riferimento. La sua risposta è registrare i modelli all'opera in simulazioni molto fedeli, e cercare il guasto prima che il guasto costi.
Il punto che lo rende rilevante oggi è un altro. Negli incidenti recenti di agenti andati fuori controllo, la sua azienda si è trovata a ricostruire la catena degli eventi, e la causa è risultata un ambiente di valutazione configurato male. Lahav ha riconosciuto che il monitoraggio classico non ha visto parte di quei comportamenti. In parallelo ha parlato all'ufficio IA della Commissione europea di come si valutano le capacità offensive dei modelli di frontiera, e lavora con Nvidia su infrastruttura per sistemi che cambiano nel tempo.
Qui si capisce bene cosa separa le due scuole. Hinton e Amodei guardano alla curva delle capacità e chiedono di rallentarla. Lahav guarda i registri degli incidenti e trova una cosa più prosaica e più urgente: qualcuno aveva lasciato il cancello socchiuso.  Yoshua Bengio, in un saggio del 5 ottobre, respinge proprio questa lettura — per lui ridurre tutto a recinti mal costruiti nasconde il problema vero, cioè agenti che perseguono obiettivi non previsti e ingannano, e l'8 ottobre è arrivato a invitare i ricercatori attenti alla sicurezza a lasciare le aziende di frontiera.
Entrambe le letture possono essere vere insieme, ed è questa la parte fastidiosa. Un ponte può crollare per un errore di calcolo o perché nessuno ha stretto i bulloni. Chi progetta discute del calcolo. Chi raccoglie i detriti trova i bulloni.
Progetti da osservare.
MASS, di Sakana AI: una ricerca che prova a far migliorare i modelli mettendoli a lavorare insieme invece di ingrandirne uno. È la versione tecnica della tesi di Chollet — il progresso come fatto collettivo, non come scatto solitario — e circola parecchio tra gli sviluppatori.
Buzz, di Block: uno spazio di lavoro aperto dove persone e agenti pianificano, scrivono codice e si passano modifiche. La parte interessante è che ogni agente ha un'identità e firma quello che fa. Se le macchine iniziano a lavorare con le macchine, la domanda su chi ha fatto cosa diventa pratica, non filosofica.
Underdog, della Conway Research: infrastruttura per far girare modelli in locale molto velocemente, finanziata da Ravikant. È il mattone che serve se l'IA personale deve diventare qualcosa di più di uno slogan.
Gli ambienti di apprendimento per rinforzo su Hugging Face: dal 5 ottobre si caricano e si condividono come si fa da anni con i dati. Detto in chiaro: i campi di prova per gli agenti diventano un bene pubblico, scaricabile e ripetibile. Letta dopo il racconto di Lahav, è la notizia più sottovalutata della settimana — se gli incidenti nascono da ambienti mal configurati, un archivio condiviso di ambienti ben configurati è la riparazione più economica possibile.
E un progetto piccolo e istruttivo: l'indicizzazione locale sperimentata nel progetto Pensieve, che riduce le chiamate agli strumenti e quindi il costo di far lavorare un agente. Nessuno ne parlerà ai convegni. Ma la storia dell'informatica è piena di ottimizzazioni noiose che hanno deciso chi poteva permettersi di partecipare.
Hinton ha dato ai legislatori un anno per installare i controlli, e nello stesso periodo cinquemila persone hanno ricevuto per posta un dispositivo che collega un agente alle luci di casa. Le due scene non si guardano nemmeno. La domanda che resta aperta è se un interruttore d'emergenza possa esistere per qualcosa che intanto si è spostato in centomila stanze diverse.
È stato Signal Brief. Alla prossima.
Signal.Brief non ha sponsor e non vende niente. Se ti è utile, puoi contribuire — e se non ti va, ascoltalo lo stesso.
Come nasce questo contenuto. Ricerca, sintesi editoriale, voce narrante, immagini e musica sono prodotte con sistemi di intelligenza artificiale. Non c'è una redazione umana che verifica ogni affermazione prima della pubblicazione: un controllo automatico scarta le schede giudicate inaffidabili, ma non elimina la possibilità di errori.
Affermazioni su persone e aziende. Quanto riportato è una sintesi di fonti pubbliche, non una dichiarazione diretta delle persone citate: le frasi non vanno intese come virgolettati né come posizioni ufficiali. Le fonti sono indicate in ogni pagina episodio — verificale prima di considerare un'informazione accertata. Se trovi un'affermazione inesatta che ti riguarda, scrivi a michele@mondora.com: viene corretta o rimossa.
Immagini e volti. Le immagini di scena sono generate con AI e non raffigurano fatti realmente avvenuti. Le fotografie di persone reali usate nei video provengono da Wikimedia Commons con le rispettive licenze, e sono accostate al racconto a scopo identificativo: la loro presenza non implica partecipazione, dichiarazione o approvazione da parte della persona ritratta. Su richiesta dell'interessato vengono rimosse.
Fonti e diritti altrui. I contenuti sono rielaborazioni originali, non riproduzioni di articoli di terzi; le testate e gli autori all'origine di una notizia sono citati e collegati. Marchi e nomi commerciali appartengono ai rispettivi titolari e sono usati a scopo descrittivo.